Компания работала в системе электронного документооборота (СЭД) «1С:Документооборот»: договоры и служебные записки регистрировались, задачи и поручения ставились в систему, у каждого документа был номер и папка. Рядом жили ещё три места, где лежали документы: файловое хранилище с проектной и рабочей документацией, корпоративная почта и переписка в мессенджерах. Формально порядок был — но нужный документ всё равно находили руками, переспрашивая коллег, и дольше всего искался не сам файл, а понимание, какая из четырёх его версий сегодня считается рабочей.
Профиль компании в разборе
- Роль: инжиниринговая компания с собственным проектным отделом, несколько площадок и работа с подрядчиками
- Штат: около 420 сотрудников, из них около 90 человек ежедневно работают с документами: проект, снабжение, договорной отдел, бухгалтерия, служба качества
- Город: Екатеринбург, площадки в двух регионах
- Системы: «1С:Документооборот» (СЭД, система электронного документооборота), файловое хранилище проектной документации, корпоративная почта, «1С:Бухгалтерия»
- Что ведём: базу договоров и переписки с контрагентами, комплекты проектной и рабочей документации, входящую и исходящую корреспонденцию
Поиск документа выглядит мелочью на фоне крупных задач, но именно он съедает рабочий день. По опросу сервиса Weeek среди 1 140 специалистов российских компаний (данные приводит «Известия» 1 июля 2026 года), в среднем сотрудник тратит около 1 часа 50 минут в день на поиск информации и восстановление рабочего контекста — это почти 38 часов, или пять рабочих дней в месяц, а за год 452 часа, то есть более 56 рабочих дней. Пятая часть опрошенных теряет на этом от двух до трёх часов ежедневно. «Восстановление контекста» — самая дорогая часть: это не поиск файла, а попытка вспомнить, чем закончилось обсуждение, какие правки согласованы и что решили в итоге.
Мир здесь не стоит на месте: рынок систем документооборота в России по итогам 2025 года участники оценивают в 95–110 млрд рублей, но основной объём выручки даёт поддержка уже установленных систем, а не новые внедрения (обзор TAdviser). При этом, по данным сервиса «Мое дело» (июнь 2026 года), полностью на электронный документооборот (ЭДО) перешли лишь 10% российских компаний: документы «живут» в разных системах — учётной, клиентской, документной и сетевых хранилищах, — данные дублируются, а часть документов просто теряется. Новую систему под эту задачу строить не нужно: нужен слой, который находит нужное в том, что уже есть.
Коротко
ИИ-агент — программа, которая по заданному правилу сама читает документы, письма и вложения и выполняет шаги — подключается к системе документооборота, файловому хранилищу и почте. Он ищет нужное по смыслу запроса, а не по названию файла, поднимает актуальную редакцию, показывает источник и объясняет вывод словами. Решение о том, что делать с найденным, остаётся за человеком. Первый шаг — бесплатный разбор стратегии внедрения ИИ на одном отделе и одном типе документов.
Содержание
- Почему нужный документ находится поздно
- Что съедает время между «нужен документ» и «документ найден»
- Что делает ИИ-агент поверх системы документооборота и хранилищ
- Какие риски это снимает
- Сколько часов это возвращает
- Что остаётся за человеком
- Как это выглядит на практике
- Как внедрить поэтапно
- Источники
Почему нужный документ находится поздно
Задача выглядит простой: есть документ, есть сотрудник, который его ищет. На практике между ними стоят пять препятствий, и каждое по отдельности выглядит терпимо.
Документ живёт не в одном месте. Договор зарегистрирован в системе документооборота, скан — в файловом хранилище, правки — в почте, а решение по спорному пункту — в переписке в мессенджере. Ни один поиск не видит все четыре места сразу, поэтому человек ищет там, где искать привык, и часто не находит.
Название файла не совпадает с содержанием. «Договор_финал_2.pdf», «Договор от 14.03 (1).doc», «Проект_итог_правки_Петров» — по этим именам невозможно понять, чем один файл отличается от другого. Работает поиск по названию только у того, кто сам эти файлы так назвал, то есть у одного-двух человек.
Версий больше, чем документов. Один и тот же договор существует в редакции заказчика, в редакции с правками юриста и в редакции, которую в итоге подписали. Актуальная версия определяется не датой создания файла, а историей: что подписано, что приложено к последнему письму, что лежит в папке «подписано». Пока это правило держится в голове, компания регулярно работает по устаревшей редакции.
Контекст хранится в переписке. Ответ на вопрос «почему здесь такая цена» лежит не в договоре, а в цепочке писем трёхмесячной давности. Чтобы его найти, нужно помнить участников и примерную дату — а если человек новый или вернулся из отпуска, он этого не помнит вовсе.
Поиск нигде не измеряется. Компания не знает, сколько времени уходит на поиск и сколько раз за месяц брали не ту версию. Без этих чисел задача не попадает в план: у неё нет владельца, потому что она «не проблема, а так, суета».
Что съедает время между «нужен документ» и «документ найден»
Если разложить путь от вопроса до найденного документа, картина повторяется из раза в раз:
- Формулировка запроса. Человек помнит смысл («акт по площадке за второй квартал»), но не помнит названия файла и папки.
- Перебор мест. Система документооборота, файловое хранилище, почта, мессенджер. Каждое место ищется по-своему, и это четыре разных поиска вместо одного.
- Перебор формулировок. Поиск по названию требует угадать слово: «акт», «КС-2», «форма», название подрядчика, сокращение, опечатку в нём.
- Сверка версий. Файл найден — но их три, и нужно понять, какая редакция рабочая.
- Восстановление контекста. Чтение переписки вокруг документа: какие правки согласованы, чем закончилось обсуждение, что решили.
- Обращение к коллеге. Самая частая точка: если не нашлось за пять минут, вопрос уходит человеку, который «точно знает». Он знает потому, что искал раньше, — но его время тоже стоит денег.
- Оформление результата. Найденное нужно собрать в один комплект: для совещания, для проверки, для ответа контрагенту, для аудита.
Каждый пункт — минуты. Вместе они и дают 1 час 50 минут в день из опроса: это не преувеличение, а сумма мелочей, которые нигде не регистрируются.
Что делает ИИ-агент поверх системы документооборота и хранилищ
Агент не заменяет систему документооборота и не переносит архив. Он подключается к тому, что уже работает, и возвращает результат туда же.
- Читает документы из всех мест. Регистрационные карточки и файлы из системы документооборота, документы с файлового хранилища, письма и вложения из почты. Не всё подряд, а заданный контур: например, договоры, дополнительные соглашения, акты и переписка по ним.
- Разбирает содержимое. Текст документа, а не только имя файла, реквизиты, стороны, суммы, даты, номера редакций. Так запрос «акт за второй квартал по площадке в Казани» перестаёт зависеть от того, как назван файл.
- Связывает документы между собой. Договор — дополнительное соглашение — акт — счёт — переписка. Это и есть «восстановление контекста»: агент показывает не один файл, а историю по документу.
- Определяет актуальную версию. По правилу, заданному человеком: что приложено к последнему письму, что отмечено подписанным, что лежит в финальной папке. Расхождения агент помечает, а не сглаживает.
- Отвечает на вопрос, а не выдаёт список. Вместо «вот 40 файлов» — короткий ответ, за ним источники: конкретные документы со ссылками и с выдержками, по которым видно происхождение вывода.
- Собирает комплект. По запросу «подготовь всё по этому подрядчику к проверке» — подборка документов в нужном порядке, с пометкой, чего в комплекте не хватает.
- Ведёт журнал. Кто спросил, что получил, из каких документов собран ответ. Это основа доверия к системе и одновременно защита сотрудника: видно, на чём основано решение.
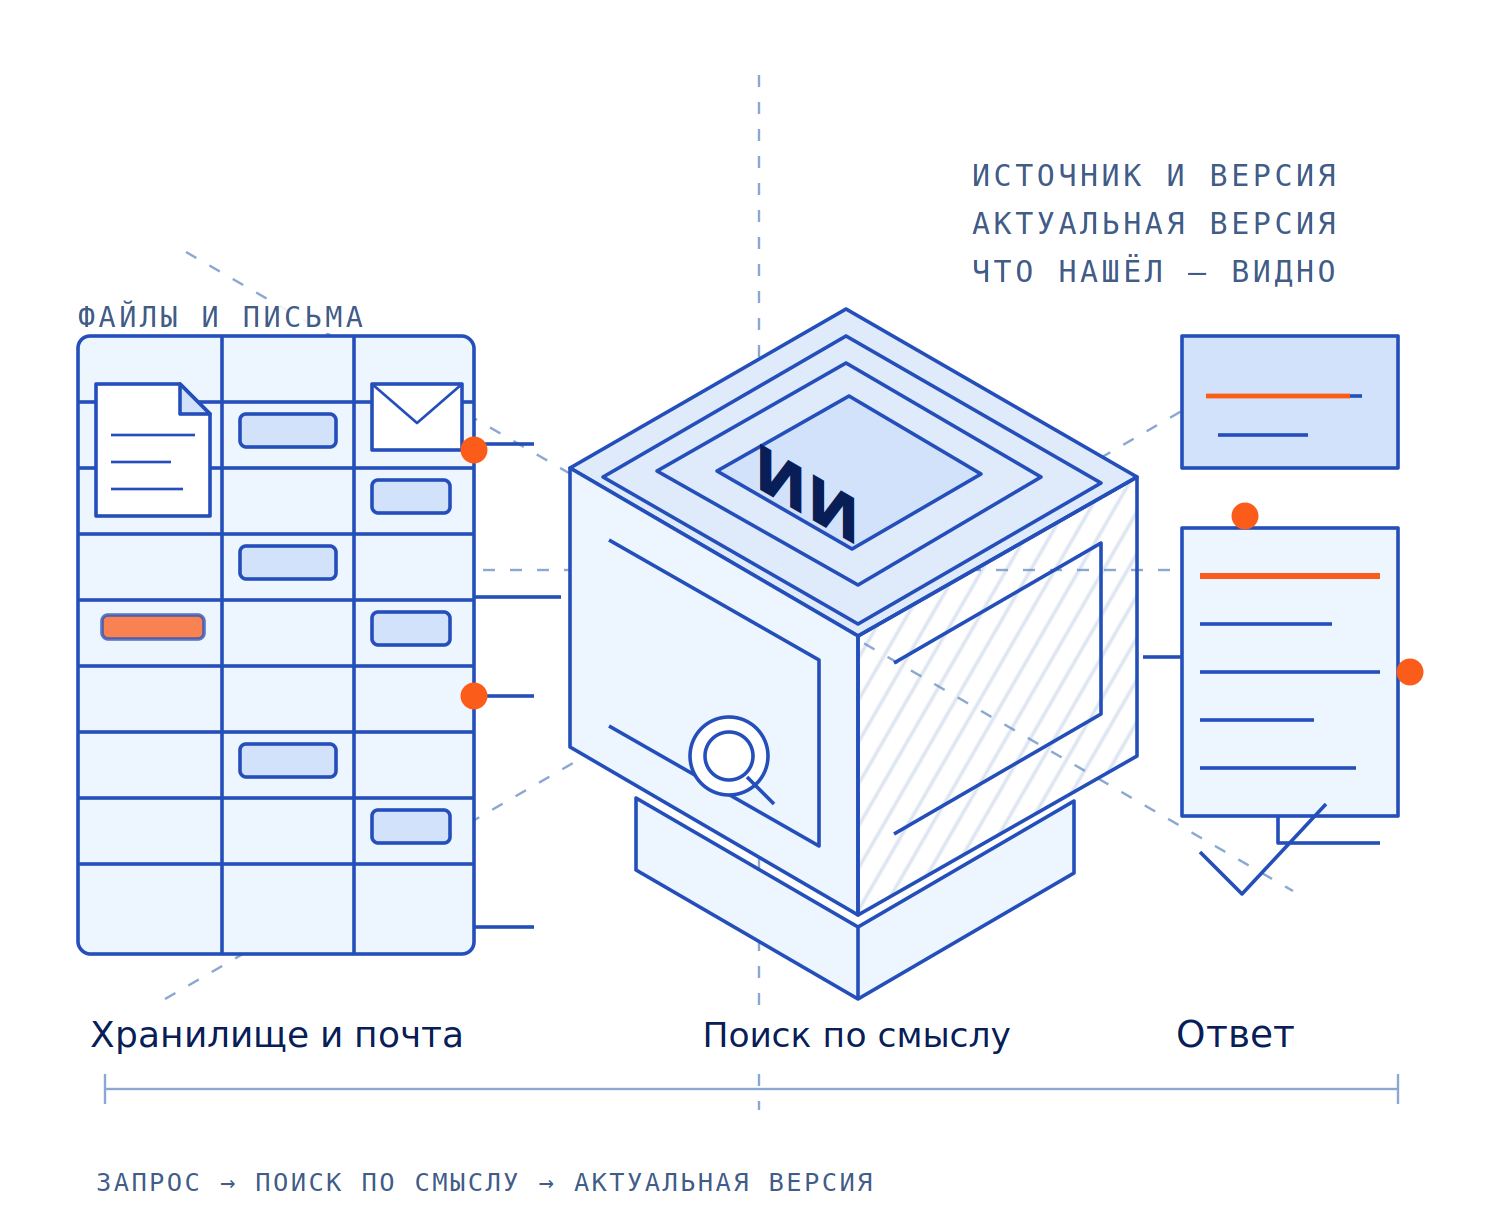
Смысл перемены в том, что запрос перестаёт зависеть от памяти сотрудника. Раньше ценность была в том, кто знает, где что лежит; теперь это знает система, а человек занимается решением. Технически такой поиск опирается на два механизма: поиск по смыслу, который сопоставляет вопрос с фрагментами документов, и метаданные, которые агент обогащает сам — тип документа, дата, контрагент, принадлежность к проекту. Исследование подходов к корпоративному поиску с обогащением метаданных с помощью языковых моделей показывает, что качество выдачи в корпоративных базах документов зависит не только от модели, но и от того, размечены ли документы: без метаданных система отвечает хуже даже на сильной модели (препринт, рецензирование не завершено).
Какие риски это снимает
Экономия минут — не главный аргумент. Ставка выше: документ — это основание для решения, и ошибка в нём стоит дороже, чем время на поиск.
Решение по устаревшей редакции
Самая дорогая ошибка в документообороте: работу запускают по редакции, которую уже заменили. Инженер берёт спецификацию предыдущей версии, снабжение заказывает по старой цене, договор подписывают с правками, которые юрист уже снял. Переделка стоит времени всех участников, повторного согласования и, если речь о закупке, разбирательства с поставщиком. Риск снимается не «внимательностью», а правилом актуальности и одним ответом системы на вопрос «какая версия рабочая».
Срыв срока из-за ненайденного документа
Ответ контрагенту, запрос от регулятора, документы к оплате — у этих задач есть дата. Если документ не найден к сроку, дальше идут сдвиг закрытия объёмов и оплаты, неустойка по договору и позиция просящего в переговорах. Документ при этом существует: он лежит на диске, и никто не может его найти за разумное время.
Спор, в котором нет доказательной базы
Разбирательство с контрагентом выигрывает тот, у кого собрана переписка и все редакции документа. Собрать их задним числом — отдельная работа на дни: поднять почту, восстановить цепочку согласований, доказать, какая версия направлялась. Компания, у которой такая сборка занимает минуты, в споре сильнее — независимо от того, кто прав по существу.
Знания уходят вместе с человеком
Классическая «корпоративная амнезия»: сотрудник, который помнил, где что лежит и почему принято именно такое решение, уходит в отпуск или увольняется, и целый пласт контекста уходит с ним. По опросу, приведённому выше, восстановление рабочего контекста — часть тех самых 452 часов в год на сотрудника. Зависимость от одного носителя знания — это риск непрерывности, а не кадровая мелочь.
Разный объём прав у разных людей
Документы бывают разные: кадровые, коммерческие, юридические. Чем проще становится поиск, тем важнее, чтобы он не расширял доступ. Агент должен видеть ровно то, что видел бы сотрудник с его ролью, а обращения — фиксироваться в журнале. Это требование ставится до пилота, а не после.
Потеря управляемости в архиве
Когда документы разбросаны по папкам, дискам и почтовым ящикам, компания не может ответить на простые вопросы: сколько у нас действующих договоров с этим подрядчиком, все ли акты подписаны, что не закрыто. Без этого нет ни контроля сроков хранения, ни понимания, что происходит с документами после ухода людей.
Сколько часов это возвращает
Часы — следствие. Но их полезно посчитать, чтобы понимать масштаб. Ниже типовой расчёт для 15 сотрудников, которые ежедневно ищут документы и контекст; вводные берите свои, методика не меняется.
| Показатель | Вручную | С агентом |
|---|---|---|
| Сотрудников, работающих с документами | 15 | 15 |
| Поиск документа по описанию | 12 минут | 1 минута |
| Восстановление контекста по переписке | 20 минут | 3 минуты |
| Сборка комплекта к совещанию или проверке | 3 часа в неделю | 40 минут в неделю |
| Возвращённое время на человека | — | 30–35 минут в день |
| Возвращённое время на команду | — | около 150 часов в месяц |
| В деньгах при стоимости часа 1 300 ₽ | — | около 195 000 ₽ в месяц |
Арифметика открытая: 15 сотрудников × 33 минуты × 21 рабочий день — это около 10 400 минут, то есть примерно 173 часа в месяц; при стоимости часа 1 300 рублей получается около 225 000 рублей, и в таблице стоит консервативная оценка — 150 часов и около 195 000 рублей. Почему такая цифра вообще возможна: из 1 часа 50 минут в день, которые сотрудник тратит на поиск и восстановление контекста, агент закрывает не всё, а ту часть, которая приходится на документы и переписку, — треть этого времени. Остальное остаётся людям: согласования, решения, разговоры. Формулировка «типовой расчёт» здесь принципиальна: это математика на заявленных вводных, а не замер чужого результата. Считать эффект нужно на своих числах: подставьте своё количество сотрудников и свою долю времени, которую реально убирает агент.
Что остаётся за человеком
Границу ответственности нужно задать до пилота, а не после первой ошибки:
- Решение — только человек. Агент показывает документ, версию и источник. Подписывать, согласовывать, отправлять и оплачивать — по-прежнему задача людей.
- Правило актуальности задаёт человек. Что считается рабочей редакцией, как учитываются правки и приложения — это управленческая настройка, а не вывод системы.
- Права менять документы у агента отсутствуют. Он не редактирует, не удаляет и не пересылает файлы, не меняет статусы в системе документооборота: только чтение, сопоставление и подготовка ответа.
- Отправка наружу — вручную. Ответ контрагенту или регулятору отправляет сотрудник: агент готовит черновик и подборку.
- Спорные версии разбирает человек. Там, где редакции противоречат друг другу по существу, решает юрист или руководитель.
- Полный журнал. Любой вывод объясним: по каким документам он собран и кто его запрашивал.
Такая рамка снимает главный страх при внедрении: система не получает права распоряжаться документами, она получает право их находить и объяснять.
Как это выглядит на практике
В проектах, где мы начинали с документов, первый шаг почти всегда один и тот же — инвентаризация данных, а не настройка агента. Мы сверяли, что реально живёт в системе документооборота, а что — в файловом хранилище, почте и папках сотрудников: где дублируются договоры, где лежат по три версии одного акта без пометок, где документы названы так, что по имени ничего не понять, а часть переписки, без которой документ не читается, живёт только в почтовых ящиках у двух человек. Затем фиксировали правило актуальности и запускали поиск на живых запросах: сотрудники формулировали вопросы так, как спрашивают обычно, — своими словами, без номеров и названий файлов.
Набор систем в тестовых контурах был разным — от документооборота на базе «1С» до почтовых ящиков и сетевых дисков, — но принцип один: данные уже есть, не хватает слоя, который их читает и связывает. Основной эффект дали не модели, а подготовка: единые правила именования, разметка типов документов и связка «договор — акт — переписка». Без этого поиск отвечал быстро, но неполно, и сотрудники возвращались к привычке спрашивать коллегу.
Практический вывод: начинать нужно не с агента, а с одного вопроса — «какие документы мы ищем чаще всего и что делает ответ правильным». Как устроены соседние сценарии, мы разбирали в материалах про девять операций с документами, про искусственный интеллект в электронном документообороте и про проверку договоров агентом в 1С:Документооборот. Если сейчас выбираете платформу, пригодится сравнение систем электронного документооборота, а для системного взгляда — разбор возможностей Directum RX.
Как внедрить поэтапно
- Выберите один тип документов и один отдел. Договоры или акты, один отдел за один месяц. Поиск «сразу по всему архиву» превращается в проект без конца.
- Опишите контур данных. Что агент читает: систему документооборота, хранилище, почту. Что не читает: закрытые папки, личные ящики, кадровые документы.
- Зафиксируйте правило актуальности. Что считаем рабочей редакцией, как учитываем вложения и подписи, как поступаем с противоречиями.
- Прогоните поиск на закрытых запросах. Соберите 30–50 реальных вопросов сотрудников и заранее известные правильные ответы — так появляется эталон, и видно, где агент ошибается.
- Ограничьте права явно. Чтение и подготовка ответа. Без права менять документы и статусы, без отправки наружу.
- Померьте четыре числа. Время на поиск одного документа, число обращений к коллегам, срок сборки комплекта и доля случаев с неактуальной версией. Это основание расширять пилот на следующий отдел.
Поиск по названию работает, когда человек помнит, как файл назван и где лежит. ИИ-агент ищет по смыслу: по тому, что спрашивают, — «акт за прошлый квартал по подрядчику на площадке в Казани». Он смотрит внутрь документов, писем и вложений, связывает их между собой и возвращает список с пояснением, почему счёл каждый документ подходящим. Название файла при этом не главное: подойдёт и «IMG_2043.pdf», если внутри нужный акт.
Нет. Агент подключается к тому, что уже работает: к системе электронного документооборота, файловому хранилищу, корпоративной почте и учётной системе. Переносить архив в новое место — это отдельный дорогой проект, и начинать с него не нужно. Начать разумнее с одного хранилища и одного типа документов: посмотреть, что там реально лежит, как называются файлы и версии, и проверить поиск на живых запросах сотрудников.
Он умеет это показать, но правило актуальности задаёт человек. Агент читает даты, авторов, номера редакций и историю изменений, отслеживает, какая версия приложена к последнему письму, и помечает расхождения. Если версии противоречат друг другу, он говорит об этом прямо, а не выбирает молча. Финальное правило — например, «актуальна редакция, приложенная к последнему исходящему письму с подписью» — фиксируется до запуска.
Права наследуются от системы: агент видит то же, что видел бы конкретный сотрудник с его ролью, и не расширяет доступ. Кадровые, юридические и коммерческие папки закрываются отдельно, а каждое обращение к документу попадает в журнал. Агент не пересылает документы наружу, не меняет их и не удаляет: его роль — чтение и подготовка ответа.
Разбор одного процесса на ваших данных: смотрим, где живут документы, сколько времени уходит на поиск и восстановление контекста, какие правила уже есть и что мешает. На выходе — карта шагов, где теряется время, и предложение по первому пилоту с понятными метриками. Ничего перестраивать и покупать для этого не нужно.
Четыре числа до и после пилота: время на поиск одного документа по описанию, число обращений за помощью к коллегам, срок сборки комплекта к проверке или совещанию и доля случаев, когда взяли неактуальную версию. Считать их нужно на одних и тех же типах запросов и одинаковым правилом, иначе сравнение будет нечестным.
Что в итоге
Документы есть у всех, но найти нужный — отдельная работа, которая нигде не учтена. Документ живёт в четырёх местах одновременно, называется так, что по имени его не узнать, существует в нескольких версиях, а контекст решения спрятан в переписке. Отсюда и цифры: по опросу Weeek, приведённому «Известиями», сотрудник тратит на поиск и восстановление контекста около 1 часа 50 минут в день — 452 часа в год, более 56 рабочих дней. Складываются эти часы из минут, поэтому их никто не замечает, пока не начинают считать.
Агент поверх системы документооборота, файлового хранилища и почты закрывает именно эту задержку: ищет по смыслу запроса, поднимает актуальную редакцию, связывает документы с перепиской и объясняет, откуда взял ответ. Новую систему для этого строить не нужно, рынок систем документооборота и без того сместился от новых внедрений к поддержке того, что уже установлено. Начинать стоит с одного отдела и одного типа документов — и с бесплатного разбора стратегии внедрения ИИ, где видно, где именно в вашем контуре теряется время. Общий подход к таким проектам разобран в статье с чего начать внедрение ИИ в бизнес-процессы.
Источники
- «Известия», публикация от 01.07.2026 со ссылкой на опрос сервиса Weeek среди 1 140 специалистов российских компаний: в среднем сотрудник тратит около 1 часа 50 минут в день на поиск информации и восстановление рабочего контекста — это почти 38 часов, или пять рабочих дней в месяц, и 452 часа, или более 56 рабочих дней, за год; 25% опрошенных тратят до часа в день, ещё 25% — от часа до двух, 23% — от двух до трёх часов: iz.ru
- TAdviser, обзор «СЭД (рынок России)»: по итогам 2025 года объём российского рынка систем электронного документооборота, управления контентом и корпоративных платформ участники оценивают в диапазоне 95–110 млрд рублей, динамика замедлилась, основной объём выручки даёт поддержка установленных систем; по данным сервиса «Мое дело» (июнь 2026 года) полностью на электронный документооборот перешли лишь 10% российских компаний, а документы «живут» в разных системах, дублируются и теряются (комментарий «К2Тех»): tadviser.ru
- IDC, аналитический материал «The High Cost of Not Finding Information»: типовой работник умственного труда тратит около 2,5 часа в день, или примерно 30% рабочего времени, на поиск информации — исходная оценка, на которую ссылаются отраслевые обзоры: computhink.com (PDF)
- IBM, справочный материал с цитатой данных IDC о 2,5 часах в день и примерно 30% рабочего времени, уходящих на поиск информации: ibm.com
- «Компьютерра», материал «Корпоративная амнезия: почему компании теряют миллионы на поиске информации»: по данным международных консалтинговых компаний сотрудники тратят на поиск и сбор информации от 1,8 до 2,5 часа ежедневно — почти 30% рабочего времени; там же обзор того, как компании экспериментируют с ИИ для доступа к внутренним знаниям: computerra.ru
- Препринт «A Systematic Framework for Enterprise Knowledge Retrieval: Metadata Enrichment with Large Language Models» (arXiv, рецензирование не завершено): качество поиска в корпоративных базах документов заметно зависит от обогащения метаданных — тип документа, атрибуты, связи — а не только от самой модели: arxiv.org